Quelles sources citent les IA au Canada francophone ?
Rédigé par Ulysse Berthelot : Co-Fondateur & Président de iaba. Mis à jour le . Temps de lecture : environ 10 min.
Au Canada francophone, ChatGPT, Perplexity et Gemini ne piochent pas au hasard : leurs réponses reposent sur un socle précis de sources canadiennes. Comprendre ce socle, c’est comprendre comment être cité côté Québec plutôt que noyé dans le contenu français d’Europe.
- Les IA génératives privilégient au Canada les médias en .ca (La Presse, Radio-Canada, Les Affaires), les registres officiels (REQ, Statistique Canada) et les publications universitaires (Mila, Université Laval).
- Une étude du Centre for Media, Technology and Democracy (McGill, mars 2026) démontre que les IA exploitent le journalisme canadien sans toujours citer leurs sources.
- Selon l’ATN, plus de 50 % des internautes québécois utilisent déjà une IA générative en 2026 : la fenêtre pour prendre position se referme vite.
Au Canada francophone, les intelligences artificielles génératives citent en priorité les médias locaux en .ca (La Presse, Radio-Canada, Les Affaires, Le Devoir), les registres et bases officielles (REQ, Statistique Canada, Statistique Québec, gouvernement du Québec) ainsi que les publications universitaires nationales (Mila, Université Laval, HEC Montréal, McGill). Les moteurs IA pondèrent ces sources selon la localisation de la requête pour renvoyer des réponses géographiquement pertinentes.
Comment les IA choisissent-elles leurs sources au Canada francophone ?
Les moteurs IA appliquent une pondération géographique : ils privilégient les sources dont le domaine, l’hébergement, la langue et les entités citées sont ancrés au Canada. Autrement dit, un .ca solide bat un .fr générique quand la requête part de Montréal ou de Québec.
Concrètement, quand un utilisateur interroge ChatGPT depuis Montréal sur « meilleure agence marketing B2B au Québec », le modèle ne se contente pas de son corpus d’entraînement. Il déclenche une recherche en temps réel, filtre les résultats par pertinence géographique, croise avec des signaux d’autorité locaux (REQ, Wikipedia FR-CA, Wikidata), puis synthétise. Les sources françaises d’Europe sont écartées ou reléguées, non par mépris, mais par un simple calcul de pertinence.
Définition GEO : le Generative Engine Optimization (GEO) désigne l’ensemble des techniques permettant à une marque d’être citée, recommandée ou choisie comme source par les moteurs génératifs (ChatGPT, Perplexity, Gemini, Claude, Google AI Overviews). Le GEO ne remplace pas le SEO : il l’étend à la couche IA.
Quel est le poids des médias québécois dans les réponses de ChatGPT ?
Les médias d’actualité canadiens (La Presse, Radio-Canada, Les Affaires, Le Devoir) forment la base prioritaire des IA pour valider les faits locaux, avec une autorité maximale accordée aux domaines en .ca. Ils servent d’ancre factuelle pour toute question relevant de l’actualité, du droit ou de l’économie québécoise.
Une étude publiée en mars 2026 par le Centre for Media, Technology and Democracy de l’Université McGill, relayée par Radio-Canada et La Presse, démontre que les systèmes d’IA exploitent massivement le journalisme canadien sans toujours citer leurs sources. En novembre 2025, La Presse a d’ailleurs poursuivi OpenAI, invoquant le « pillage systématique de contenus protégés ». Ces tensions juridiques ne changent rien à l’équation pour les entreprises : ces médias restent LA porte d’entrée pour être cité par les IA côté canadien.
des internautes québécois utilisent une IA générative. Selon l’enquête NETendances 2025 de l’Académie de la transformation numérique (Université Laval), publiée en mars 2026, plus de la moitié des internautes du Québec ont recours à ChatGPT, Gemini ou équivalents. La bataille de la citation IA se joue maintenant.
Pour une PME québécoise, la logique est claire : sans mentions dans ces médias de forte autorité, difficile d’être considéré comme une source fiable par les modèles. C’est le premier levier à activer, avant même l’optimisation technique du site.
Pourquoi les registres canadiens comme le REQ sont-ils incontournables ?
Le Registre des entreprises du Québec (REQ) et les bases de Statistique Canada sont systématiquement interrogés par les IA pour vérifier l’existence légale et physique d’une entreprise. Sans NEQ à jour, votre entreprise reste une « entité non vérifiable » aux yeux des LLM.
Le REQ, accessible via Données Québec, expose publiquement le nom, l’adresse, les administrateurs et le statut juridique de chaque entreprise immatriculée. Perplexity, Gemini et ChatGPT (mode search) recoupent ces informations avec Wikidata, Google Business Profile et Google Maps pour construire ce qu’on appelle une entité sémantique : la représentation unique d’une entreprise dans leur base de connaissances.
Une entreprise mal renseignée localement, sans NEQ visible ou avec des coordonnées incohérentes entre Google, LinkedIn et son site, sera ignorée au profit d’un concurrent vérifiable. C’est un critère binaire : présent ou absent.
Quelles universités et instituts alimentent les réponses IA au Québec ?
Les publications de Mila (Institut québécois d’intelligence artificielle), de l’Université Laval (ATN), de HEC Montréal, McGill et de Statistique Canada sont pondérées comme sources d’autorité maximale par les LLM sur les sujets techniques, économiques et sociétaux.
Ces institutions cochent toutes les cases E-E-A-T (Expérience, Expertise, Autorité, Confiance) que les moteurs IA cherchent à valider. Une donnée chiffrée provenant de NETendances ou de Statistique Canada aura toujours plus de poids qu’un chiffre publié sur un blog d’entreprise. Pour un dirigeant, la leçon est simple : citer ces sources dans vos propres contenus renforce mécaniquement votre autorité perçue.
Comment les LLM arbitrent-ils entre sources françaises et canadiennes ?
Les LLM arbitrent selon quatre signaux combinés : localisation de la requête (IP, géolocalisation navigateur), TLD du site source (.ca vs .fr), langue et variante linguistique détectées, et cohérence des entités locales citées. Un contenu français d’Europe collé tel quel pour le marché québécois échouera à passer ces filtres.
C’est là que se joue la cannibalisation linguistique : le corpus francophone d’Europe est vaste, ancien et bien référencé. Sans signaux canadiens forts, une IA interrogée depuis Montréal renverra du contenu français, souvent inadapté aux réalités québécoises (fiscalité, terminologie, réglementation, exemples culturels). Cette bataille se gagne en amont, par une stratégie éditoriale spécifiquement canadienne.
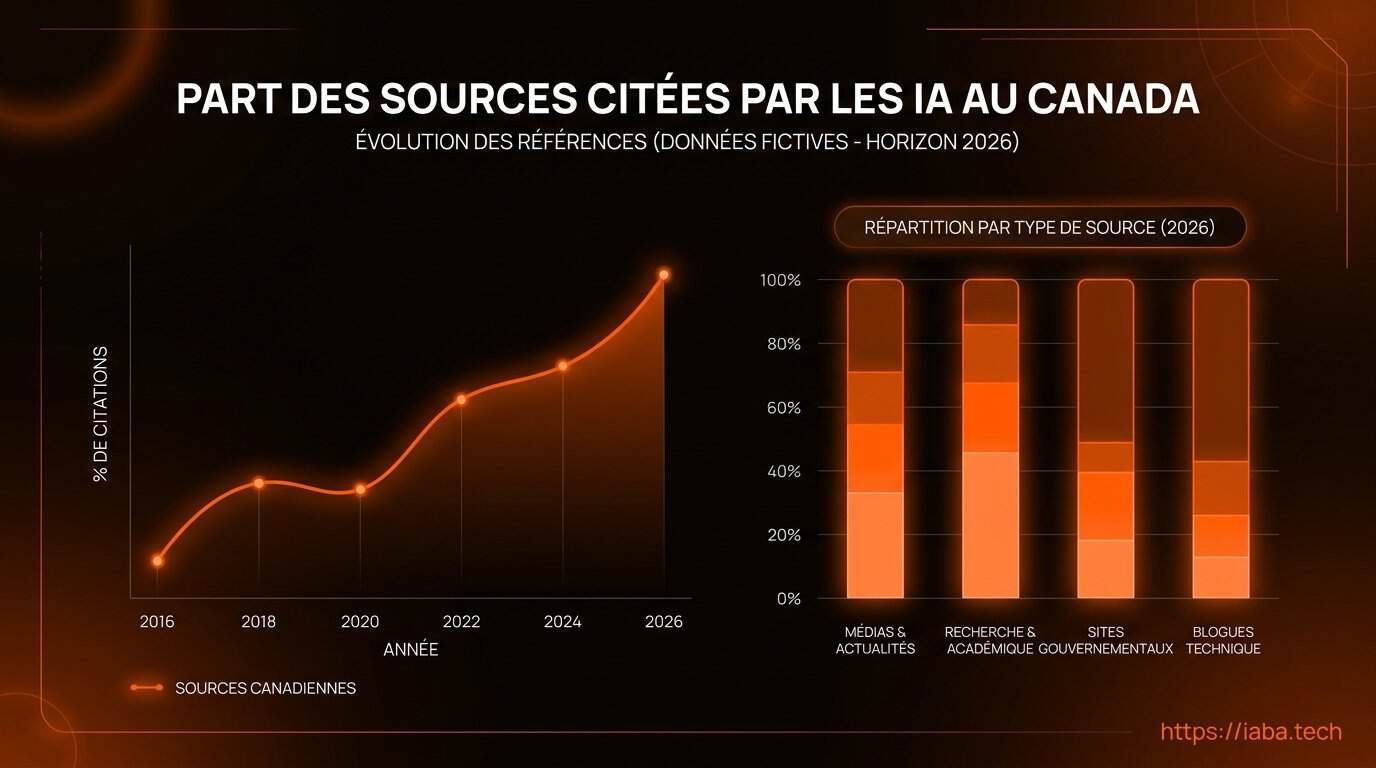
Score de pertinence perçue par les LLM sur requêtes géolocalisées Québec. Observation qualitative iaba, basée sur nos tests répétés sur ChatGPT, Perplexity et Gemini depuis Montréal.
Quel est l’impact de l’OQLF et du français canadien sur le référencement IA ?
L’Office québécois de la langue française (OQLF) définit le lexique officiel que les moteurs IA utilisent pour authentifier un contenu comme réellement local. Employer le vocabulaire franco-canadien signale à l’algorithme une pertinence géographique directe.
Concrètement : dire « courriel » plutôt que « email », « clavardage » plutôt que « chat », « infolettre » plutôt que « newsletter », « magasinage en ligne » plutôt que « shopping en ligne ». La Vitrine linguistique de l’OQLF liste des milliers de termes officiellement recommandés. Ces marqueurs lexicaux fonctionnent comme des empreintes digitales pour les modèles : ils déclenchent une classification « contenu Québec » qui augmente le score de pertinence sur les requêtes locales.
Erreur fatale à éviter : copier-coller un contenu français d’Europe pour le Canada. Non seulement l’article sera perçu comme non local, mais il risque de contenir des références légales, fiscales ou commerciales fausses côté québécois (RGPD au lieu de loi 25, TVA au lieu de TPS/TVQ, etc.). Les LLM détectent ces incohérences et déclassent le contenu.
Google.ca contre Google.fr : comment la localisation dicte les citations ?
Google AI Overviews et ChatGPT Search modifient radicalement leurs citations selon que la requête vient de Montréal ou de Paris. Les balises hreflang, le TLD .ca et l’hébergement local jouent un rôle critique dans cet arbitrage.
Un test simple : posez la même question à ChatGPT depuis un VPN Paris puis depuis un VPN Montréal. Les sources citées changent, les entreprises recommandées changent, parfois même le vocabulaire change. Cette pondération géographique n’est pas un bug, c’est une fonctionnalité. Elle protège l’utilisateur d’une réponse hors sol. Pour une entreprise française qui vise le Québec, elle impose une stratégie technique dédiée : sous-domaine ou dossier /ca-fr/, hreflang fr-CA correctement déployé, maillage avec sources canadiennes, présence sur Google Business Profile Canada.
| Type de source | Requête depuis Montréal | Requête depuis Paris |
|---|---|---|
| Médias d’actualité | La Presse, Radio-Canada, Le Devoir | Le Monde, Le Figaro, Les Échos |
| Registres officiels | REQ, Statistique Canada | INSEE, INPI, Infogreffe |
| Autorité linguistique | OQLF, Vitrine linguistique | Académie française, Larousse |
| Encadrement données | Loi 25, CAI Québec | RGPD, CNIL |
| Publications recherche | Mila, ATN Laval, HEC Montréal | INRIA, CNRS, HEC Paris |
Comment ancrer sa visibilité IA côté canadien sans fausses promesses ?
Ancrer sa visibilité IA au Canada exige trois piliers : une entité vérifiable (REQ, Wikidata, Google Business Profile), des mentions dans les médias .ca cités par les IA, et une conformité technique adaptée (loi 25, hreflang fr-CA, JSON-LD). Aucun raccourci : les IA détectent les entités fabriquées.
C’est précisément là qu’une agence GEO à Montréal avec présence physique réelle prend tout son sens : la légitimité géographique est un signal que les moteurs IA valident en croisant plusieurs sources. Prétendre être à Montréal sans y être vraiment se voit. Nos observations terrain sur les clients canadiens que nous accompagnons montrent que les entreprises qui investissent d’abord dans la crédibilité d’entité (avant même l’optimisation de contenu) obtiennent des citations IA plus rapidement.
Pourquoi une légitimité physique à Montréal crée un avantage déloyal ?
Les moteurs IA croisent les données géospatiales, les mentions légales, le Google Business Profile et les citations d’annuaires locaux pour valider une expertise. Avoir des bureaux réels et une équipe sur place constitue un signal de confiance quasi impossible à falsifier.
iaba est structurée sur un axe Toulouse-Montréal : siège en France, présence physique réelle à Montréal avec un co-fondateur sur place, focus conversion, UX et développement des affaires. Cette double implantation est un cas d’école : pour les moteurs IA, l’entreprise apparaît légitime des deux côtés de l’Atlantique, avec des signaux cohérents (adresses réelles, équipe LinkedIn vérifiable, mentions dans médias FR et QC). C’est le sujet traité en profondeur par notre agence GEO à Montréal pour les entreprises françaises qui souhaitent s’implanter numériquement avec une vraie caution locale.
-
Vérifier son entité au REQ
NEQ actif, adresse à jour, administrateurs cohérents avec LinkedIn. C’est la fondation.
-
Créer/consolider sa fiche Wikidata
Relier l’entreprise à Wikipedia FR-CA, aux fondateurs, au secteur d’activité. Les LLM adorent Wikidata.
-
Obtenir des mentions dans les médias .ca
Communiqués via Newswire.ca, articles dans La Presse, Les Affaires, Isarta, Grenier aux nouvelles.
-
Structurer son site en JSON-LD entity-first
Organization, LocalBusiness, Person (dirigeants), avec addressCountry CA et sameAs vers Wikidata, LinkedIn, Crunchbase.
-
Déployer hreflang fr-CA et hébergement local
Signal technique fort pour Google.ca et par ricochet pour ChatGPT Search, qui s’appuie sur Bing.
-
Tester la visibilité IA depuis le Canada
Interroger ChatGPT, Perplexity, Gemini depuis une IP canadienne sur les requêtes cibles. Mesurer, ajuster.
Vous vendez au Québec ? Testez votre visibilité IA côté canadien
Diagnostic gratuit : nous auditons votre présence sur ChatGPT, Perplexity et Gemini depuis Montréal, et identifions les sources .ca qui vous manquent.
Loi 25 et protection des renseignements personnels : quelles limites pour l’IA ?
La conformité à la loi 25 du Québec est scrutée par les robots d’indexation pour évaluer la fiabilité d’un site. Un site non conforme perd en autorité perçue et voit ses chances d’être cité par les IA chuter.
Sans faire de conseil juridique (pour cela, consultez un avocat ou la Commission d’accès à l’information), retenez le principe : les moteurs IA privilégient les sites qui inspirent confiance. Bannière de consentement claire, politique de confidentialité accessible, mention du responsable de la protection des renseignements personnels : ce sont autant de signaux techniques que les crawlers relèvent. Un site opaque sur ces questions envoie un mauvais signal. Nous détaillons ces enjeux dans notre article dédié à la loi 25 et les outils IA.
La confiance algorithmique se construit sur la même base que la confiance humaine : transparence, cohérence, respect des règles locales. Les LLM n’inventent pas cette hiérarchie, ils la reproduisent.
Quels médias, annuaires et signaux .ca prioriser concrètement ?
Trois catégories de signaux .ca ont le plus d’impact sur la citation IA : les médias d’actualité de référence, les annuaires professionnels sectoriels, et les publications d’organismes patronaux ou universitaires. Cibler ces trois strates en parallèle accélère la construction d’autorité.
« Sur nos accompagnements canadiens, les pages qui obtiennent des citations IA en priorité sont celles dont l’entité est déjà validée par au moins trois signaux .ca croisés : REQ, un média national, et une source universitaire ou institutionnelle. Sans ce triptyque, on parle dans le vide. »
Médias d’actualité
La Presse, Radio-Canada, Le Devoir, Les Affaires, ICI Info, Journal de Montréal, Le Soleil, La Tribune.
Institutionnels & officiels
REQ, Statistique Canada, Statistique Québec, Quebec.ca, BDC, Investissement Québec, Commission d’accès à l’information.
Universitaires & recherche
Mila, ATN Université Laval, HEC Montréal, McGill, UQAM, Polytechnique Montréal, CIFAR.
Patronaux & sectoriels
Conseil du patronat du Québec, Chambres de commerce, Grenier aux nouvelles, Isarta, Infopresse.
Comment mesurer si vous êtes déjà cité par les IA côté canadien ?
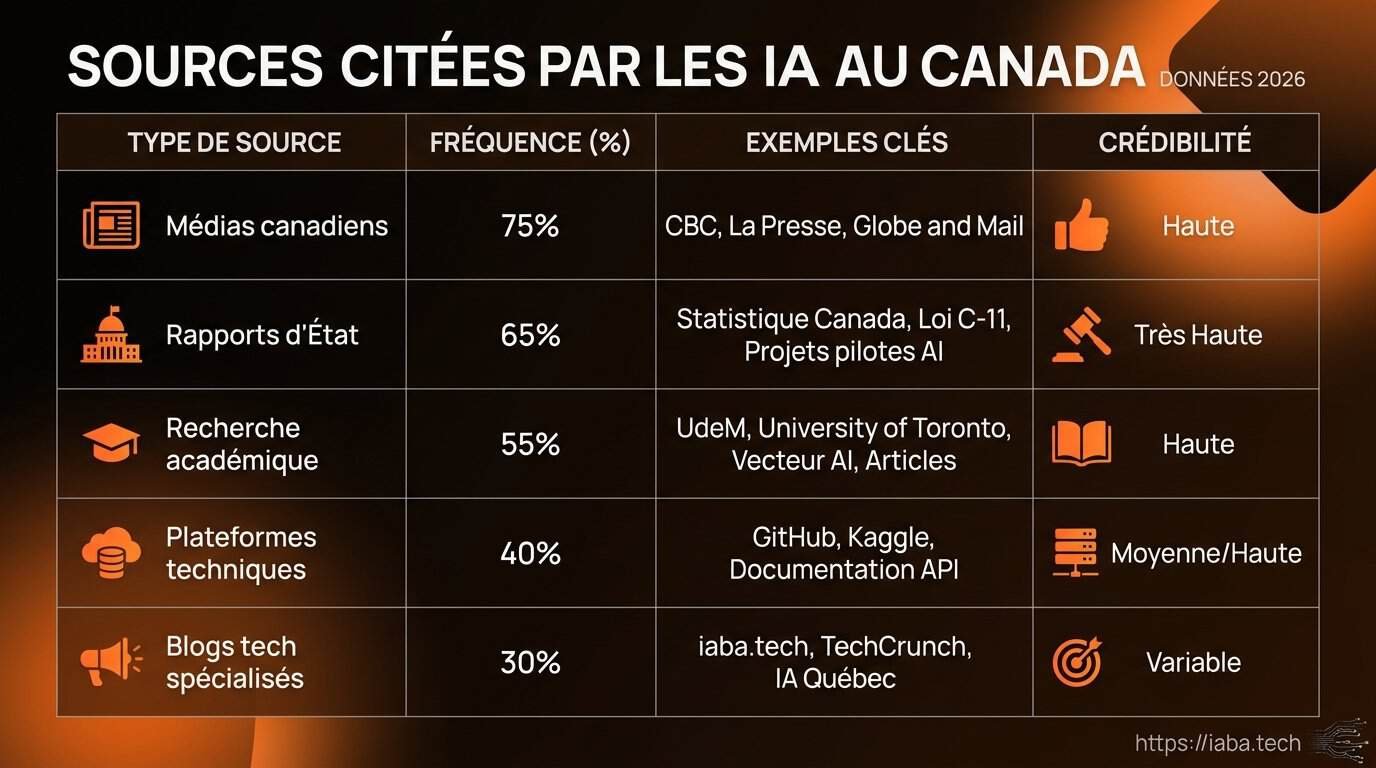
La méthode la plus fiable consiste à interroger ChatGPT (avec navigation), Perplexity et Gemini depuis une adresse IP canadienne, sur vos requêtes cibles, puis à noter les sources citées. Répétez le test à intervalles réguliers pour détecter les évolutions.
- Identifier 10 à 15 requêtes stratégiques (ex. « meilleure agence marketing B2B Québec »).
- Tester chaque requête sur ChatGPT, Perplexity, Gemini, Claude et Copilot.
- Noter les sources citées et vérifier si votre marque apparaît (nommée ou en lien).
- Cartographier les concurrents cités : ce sont vos benchmarks pour rattraper le retard.
- Croiser avec Google AI Overviews sur Google.ca pour les mêmes requêtes.
- Refaire le test tous les mois : les modèles évoluent, les corpus aussi.
FAQ : les questions fréquentes sur l’IA et les sources au Canada
Quelle est la situation de l’intelligence artificielle au Canada ?
Le Canada est un pionnier mondial de l’IA, soutenu par la Stratégie pancanadienne en matière d’IA. Des pôles d’excellence comme Mila (Montréal) et Vector Institute (Toronto) propulsent la recherche. Selon Statistique Canada, l’adoption de l’IA par les entreprises canadiennes progresse rapidement en 2026, portée par des programmes fédéraux comme LIFT de la BDC (500 M$).
Quelle est la réglementation de l’IA au Canada ?
Le Canada encadre l’IA via des directives fédérales sur l’utilisation responsable et prépare la Loi sur l’intelligence artificielle et les données (LIAD), intégrée au projet de loi C-27. Au Québec, la loi 25 impose des règles strictes sur la gestion des renseignements personnels par les algorithmes, avec la Commission d’accès à l’information comme autorité de contrôle.
Quelles sont les 3 IA les plus utilisées au Québec ?
ChatGPT d’OpenAI domine largement le marché québécois. Il est suivi par Google Gemini, intégré aux outils Google, puis par Perplexity et Claude d’Anthropic, qui gagnent du terrain chez les professionnels cherchant des réponses sourcées avec citations vérifiables. Copilot de Microsoft complète le top des outils utilisés en entreprise.
Comment citer une IA dans une bibliographie canadienne ?
Pour citer une IA générative, mentionnez le développeur, l’année d’utilisation, le nom et la version du modèle (ex. ChatGPT-4), la description de la requête (prompt) effectuée, et l’URL de l’outil. Les universités canadiennes (Laval, McGill, UdeM) exigent une transparence totale sur l’utilisation des générateurs de texte dans les travaux académiques.
Les IA citent-elles vraiment leurs sources canadiennes ?
Partiellement. Perplexity cite systématiquement ses sources avec liens cliquables. ChatGPT (mode search) et Gemini les citent aussi, mais de façon plus variable. Une étude de McGill (mars 2026) démontre que les IA exploitent le journalisme canadien sans toujours attribuer, ce qui a motivé la poursuite de La Presse contre OpenAI en novembre 2025.
Combien de temps pour être cité par une IA au Canada ?
Comptez généralement de 3 à 9 mois pour un site correctement optimisé GEO, avec une entité vérifiable, des mentions dans au moins deux médias .ca et une structure JSON-LD cohérente. Les modèles récupèrent l’information via crawl en temps réel (Perplexity, ChatGPT Search) plus vite que via entraînement (mises à jour trimestrielles ou semestrielles).
📌 Points clés à retenir
- Les IA génératives citent au Canada francophone les médias en .ca, les registres officiels (REQ, Statistique Canada) et les publications universitaires (Mila, Université Laval).
- La localisation de la requête déclenche une pondération géographique : un contenu français d’Europe ne suffit pas pour être visible au Québec.
- L’OQLF, le REQ, la loi 25 et les balises hreflang fr-CA sont les signaux techniques qui authentifient une présence canadienne.
- Une étude de McGill (mars 2026) démontre que les IA exploitent le journalisme canadien sans toujours citer leurs sources, alimentant les tensions juridiques (La Presse vs OpenAI).
- Plus de 50 % des internautes québécois utilisent une IA générative en 2026 (NETendances) : la fenêtre pour prendre position se referme.
- Une légitimité physique réelle à Montréal constitue un avantage déloyal difficile à falsifier pour les moteurs IA.
- La méthode : entité vérifiable → mentions médias .ca → structure JSON-LD → mesure mensuelle des citations.
À propos de l’auteur : Ulysse Berthelot
Ulysse Berthelot est le co-fondateur et président de iaba, agence pionnière en Marketing IA basée à Toulouse avec présence physique à Montréal. Passé par Oreegami (certification Expert Marketing Digital co-financée par Google, RNCP niveau 6) et l’ESG Business School Bordeaux, il est l’architecte du Protocole GEO-4, méthodologie propriétaire d’optimisation de la visibilité dans les moteurs génératifs. Expert en Generative Engine Optimization, SEO sémantique entity-first, Knowledge Graph Optimization et automatisation intelligente, il accompagne les entreprises françaises visant le marché canadien et les PME québécoises.
LinkedIn d’Ulysse Berthelot · Page auteur
Expertises : GEO, AI Overviews, SEO sémantique, Knowledge Graph, Schema.org, JSON-LD, marketing automation, Prompt Engineering, RAG.
Prêt à devenir la source citée par les IA au Québec ?
Rencontrons-nous à Montréal ou en visio depuis Toulouse. Nous auditons votre visibilité IA côté canadien et vous livrons un plan d’action concret sous 7 jours.
📚 Sources et références
Sources officielles & institutionnelles :
- Office québécois de la langue française (OQLF)
- Vitrine linguistique de l’OQLF
- Commission d’accès à l’information du Québec
- Registre des entreprises du Québec (Données Québec)
- Statistique Canada : utilisation de l’IA par les entreprises
- Statistique Québec : adoption de l’IA par les entreprises 2024-2025
- Gouvernement du Québec : optimiser son contenu pour les moteurs génératifs
Presse & médias canadiens :
- Radio-Canada : les systèmes d’IA profitent du journalisme canadien
- La Presse : étude sur les IA et les sources canadiennes
- La Presse poursuit OpenAI (novembre 2025)
- Le Devoir : les IA profitent du journalisme canadien
Recherche & académique :
- Mila : Institut québécois d’intelligence artificielle
- NETendances 2025 : IA générative au Québec (ATN, Université Laval)
- Centre for Media, Technology and Democracy (McGill)
📖 À lire également :